

为什么要使用领域驱动设计?
从Eric Evans的《领域驱动设计:软件核心复杂性应对之道》一书的书名就可以看出这一方法论是为了解决软件核心复杂性的。也就是说软件业务越来越复杂了,领域驱动设计可以让事情变得简单。而实际情况是:领域驱动设计的门槛很高,没有很深厚的面向对象编码能力几乎不可能实践成功。
这一说法是否自相矛盾呢?Martin Fowler在PoEAA一书中给了一个有力的解释:
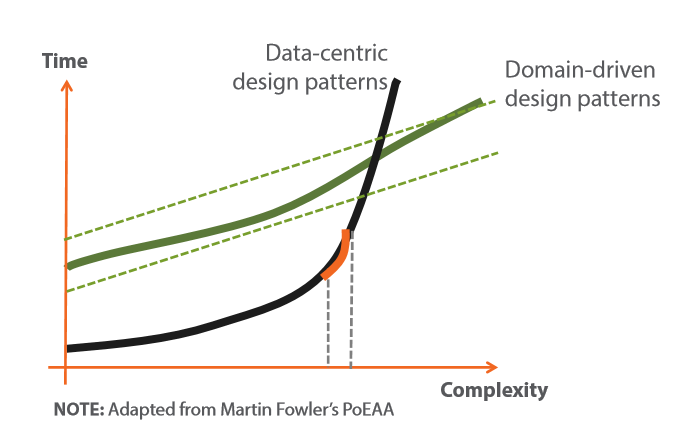
我们把三层架构等除了领域驱动之外的架构方式都可以归纳为以数据为中心的架构方式,在图中是黑色的粗实线;
领域驱动设计在图中是绿色的粗实线。
当软件在开发初期,以数据驱动的架构方式非常容易上手,但是随着业务的增长和项目的推进,软件开发和维护难度急剧升高。
领域驱动设计则在项目初期就处在一个比较难以上手的位置,但是随着业务的增长和项目的推进,软件开发和维护难度平滑上升。
这幅图形象的解释了领域驱动设计和传统的软件开发模式两者在软件开发过程中解决复杂性之间的差异。
领域驱动设计的核心是什么?
顾名思义,领域驱动设计的核心是领域模型,这一方法论可以通俗的理解为先找到业务中的领域模型,以领域模型为中心驱动项目的开发。而领域模型的设计精髓在于面向对象分析,在于对事物的抽象能力,一个领域驱动架构师必然是一个面向对象分析的大师。
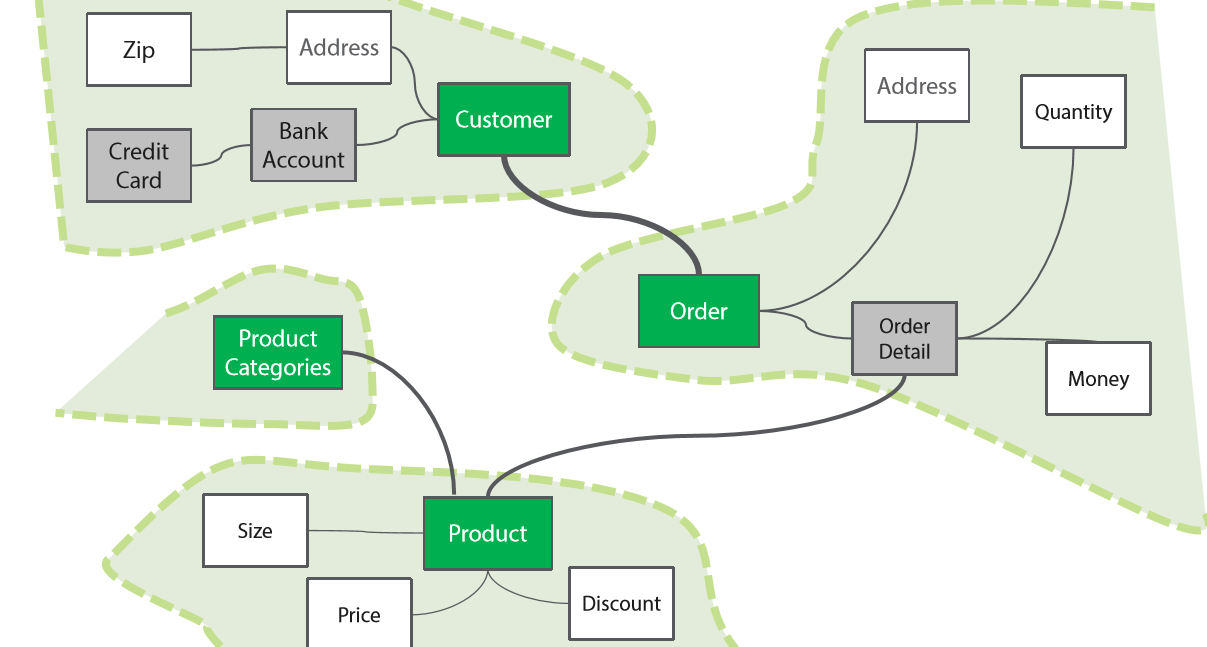
在面向对象编程中讲究封装,讲究设计低耦合,高内聚的类。而对于一个软件工程来讲,仅仅只靠类的设计是不够的,我们需要把紧密联系在一起的业务设计为一个领域模型,让领域模型内部隐藏一些细节,这样一来领域模型和领域模型之间的关系就会变得简单。这一思想有效的降低了复杂的业务之间千丝万缕的耦合关系。
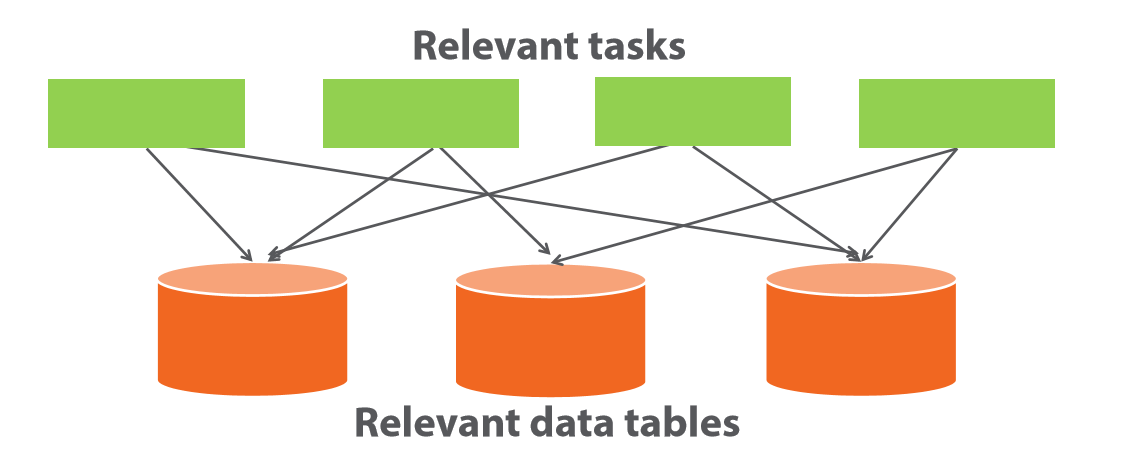
下图为“以数据为中心的架构模式”,表和表之间关系错综复杂:
下图是“领域模型”:领域和领域之间只存在大粒度的接口和交互:
初期学习DDD的朋友一定不会错过Eric Evans写的《领域驱动设计:软件核心复杂性应对之道》,这本书名气很大,也是很多人入门领域驱动设计的首选读物,这本书提到了领域驱动设计中的一些概念:Repository,Domain,ValueObject等。但是初学者有可能得出一个错误的结论:有人误认为项目架构中加入***Repository,***Domain,***ValueObject就变成了DDD架构。如果没有悟出其精髓就在项目中加入这些概念,那充其量也不过是个三层架构;反之对于一个面向对象分析的高手而言,不使用这些概念也可以实现领域驱动设计。
以Repository的设计为例,我经常看到一些文章中对IRepository定义为:
1 2 3 4 5 6 7 8 | public interface IRepository<TAggregateRoot>{ TAggregateRoot Get(int id); void Remove(TAggregateRoot aggregateRoot); void Update(TAggregateRoot aggregateRoot); //What's this? TAggregateRoot Where(Expression<Func<TAggregateRoot, bool>> filter); |
1 2 | //…} |
领域驱动设计是以领域模型为基本单位,这表明在IRepository<TAggregate>接口中,只有Get(int id),Update(TAggregateRoot aggregate),Remove(TAggregateRoot aggregate)这三个接口是有意义的。Where(Expression<Func<TAggregateRoot,bool>> filter)这一定义暴露了你是在在进行单表操作,对于领域模型来讲没有查询一说。
而对于IUserRepository这样一个稍微具体的接口定义:
1 2 3 4 5 6 7 | public interface IUserRepository : IRepository<User>{ //What's this? List<Rule> GetRules(int id); //....} |
一个IUserRepository仍然是一个Repository,他也只能以User聚合根为单位进行操作。方法List<Rule> GetRules(int id)将此Repository打回了原形,这不再是一个Repository,这是一个DAL。
正确的实现方式:

